RAG 核心概念与原理:Chunking、Embedding、相似度、HNSW 与多路召回
本文以“知识库型 RAG”为主线,梳理从文档入库到最终生成答案的完整检索链路。
核心流程:
text文档侧:文档 → 解析 → Chunking → Embedding → 索引 查询侧:Query Rewrite(可选) → Metadata Filter / 权限过滤 → 多路 Recall(Dense ANN / BM25 / 其他数据源) → Fusion(如 RRF) → Rerank → Context Construction → LLM 生成答案
目录
- 为什么需要 RAG
- Embedding:把文本变成可计算的数据
- Chunking:知识怎么切
- 相似度与距离:怎么衡量“像不像”
- HNSW:如何快速做近似最近邻搜索
- 完整检索链路:从 Query 到 Rerank
- 总结
一、为什么需要 RAG
1. LLM 的几个天然限制
直接让 LLM 回答企业内部知识、最新资料或强事实性问题,会遇到几个典型问题:
- **模型参数中的知识不是实时数据库。**模型只能利用训练阶段形成的参数知识,以及当前上下文中实际提供的信息。
- **知识不足时可能产生幻觉。**模型可能生成语言上合理、事实却错误的内容,但这不是“必然发生”,也不能简单理解为模型一定不会回答“不知道”。
- **默认无法访问企业私有知识。**内部文档、代码库、业务规则、工单、聊天记录等信息,如果没有通过上下文、检索或工具提供给模型,模型就无法可靠使用。
RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路就是:
用户问题
  ↓
从外部数据源检索相关信息
  ↓
把高相关信息加入模型上下文
  ↓
LLM 基于问题 + 检索结果生成答案因此,RAG 更准确的理解是:
在生成前,通过检索动态补充模型上下文。
检索源并不一定是“向量知识库”,也可以是:
- PDF、Markdown、Word 等文档;
- 数据库;
- 代码仓库;
- 历史对话;
- 用户记忆;
- 搜索引擎;
- API / 工具调用结果;
- 知识图谱。
“知识库问答”只是 RAG 最常见的工程形态之一,不等于 RAG 的全部。
2. 知识从哪里来
工程上可以粗略分为两类。
2.1 共享知识
相对稳定、由多人共享的数据,例如:
- 产品文档、技术方案、会议纪要;
- Git 仓库中的源码、README、API 文档、Changelog;
- 制度、流程、规范;
- FAQ、工单;
- 团队聊天记录。
2.2 用户记忆与会话状态
例如:
- 用户长期偏好;
- 历史任务;
- 最近一次讨论的对象;
- 会话中的指代关系。
这部分通常不建议简单等同于传统知识库 RAG。它还涉及:
- 主体隔离;
- 权限与隐私;
- 新旧记忆冲突;
- 生命周期;
- 记忆更新与遗忘。
因此,更合理的工程抽象是:
统一检索层
├── Knowledge Recall
├── Memory Recall
├── Conversation Recall
├── SQL / Structured Recall
├── Graph Recall
└── Web / Tool Recall3. RAG 的离线与在线流程
3.1 离线阶段:建立可检索索引
典型流程:
文档
  → 解析与清洗
  → Chunking
  → Embedding
  → 写入向量索引
→ 同时保存正文、metadata、文档关系等信息注意:工程上通常不是“只把向量存进去”。至少还要保存:
chunk_iddocument_id- 原始文本
- 标题 / 路径
- 租户、用户、权限信息
- 时间、来源
- Parent-Child 关系
- 其他业务 metadata
3.2 在线阶段:查询与生成
简化版:
Query
  → Embedding
  → ANN Top-K
  → Context
→ LLM较完整的生产链路通常是:
Query Rewrite / Expansion(按需)
  → 权限与 Metadata 约束
  → 多路 Recall
  → Fusion
  → Rerank
  → 去重 / 截断 / Context Construction
→ LLMRAG 的效果不只取决于 LLM。很多失败案例其实发生在检索阶段:
如果召回内容本身不相关,后面的 LLM 很难凭空把错误上下文修正成正确答案。
二、Embedding:把文本变成可计算的数据
1. 从字面匹配到语义匹配
传统关键词搜索主要根据词项是否出现来匹配。
例如查询:
编程语言文档:
A. 用户的编程语言是 Go
B. 用户写 Go 和 Python
C. 用户的技术栈是 Go纯字面搜索最容易命中 A,而 B、C 虽然语义相关,却可能因为没有出现“编程语言”而得分较低甚至漏掉。
Embedding 的目的,就是把文本映射为向量,让“语义相关性”可以通过数学计算近似衡量。
2. 什么是向量
向量可以理解为一组有序数字:
[0.21, -0.43, 0.07, 0.85, ...]Embedding 的维度由模型决定,可能是几百、上千甚至可配置维度。不要把 768 / 1024 / 1536 当成固定标准。
在 RAG 中:
文本 → Embedding Model → 固定维度向量查询时再执行:
Query → 同一套兼容的 Embedding 编码方式 → Query Vector然后在向量空间中查找最接近的文档向量。
3. 什么是 Embedding 模型
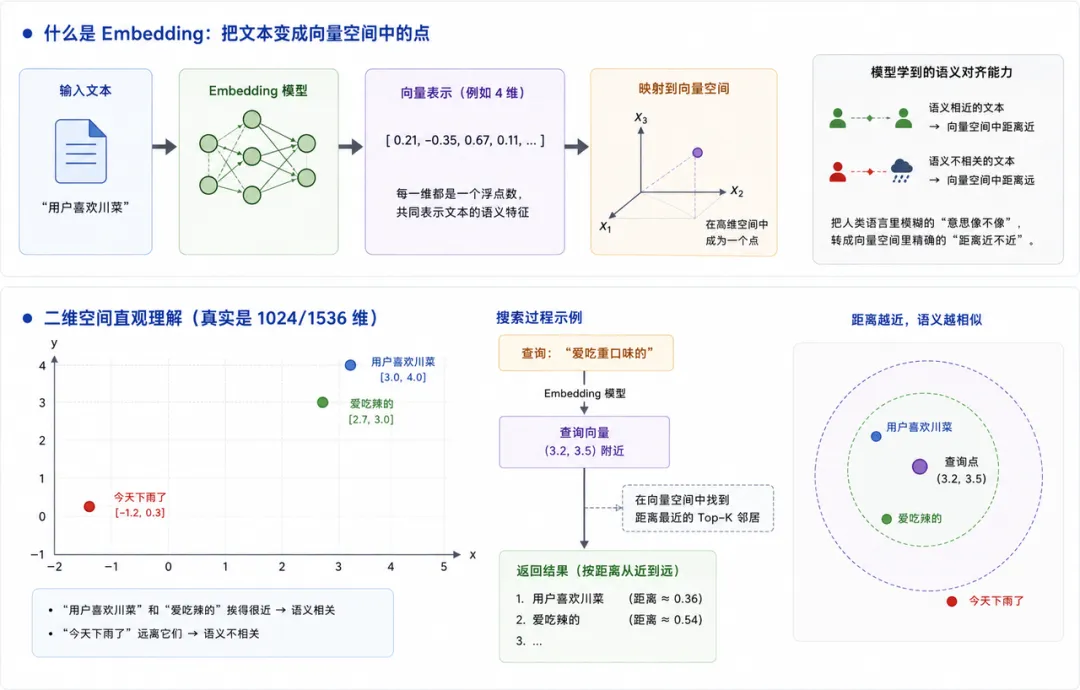
Embedding 模型把文本、图片或其他输入编码为向量表示。
对于文本检索,一个好的模型应当让:
- 语义相关的 query / document 在目标相似度空间中得分较高;
- 不相关内容得分较低。
例如:
“数据库连接池”
“DB connection pool”即使字面差异明显,Dense Embedding 仍可能把它们映射到相近区域。
但不要把 Embedding 理解成“模型真正理解了语义坐标轴”。单个维度通常没有稳定的人类可解释含义,真正有意义的是整个向量表示及其相对关系。
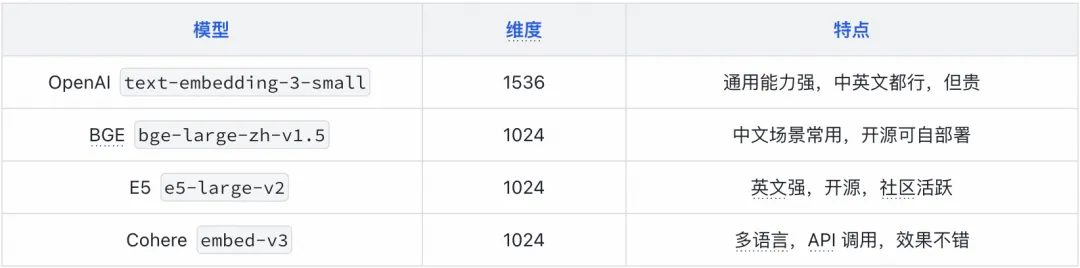
主流 Embedding 模型:
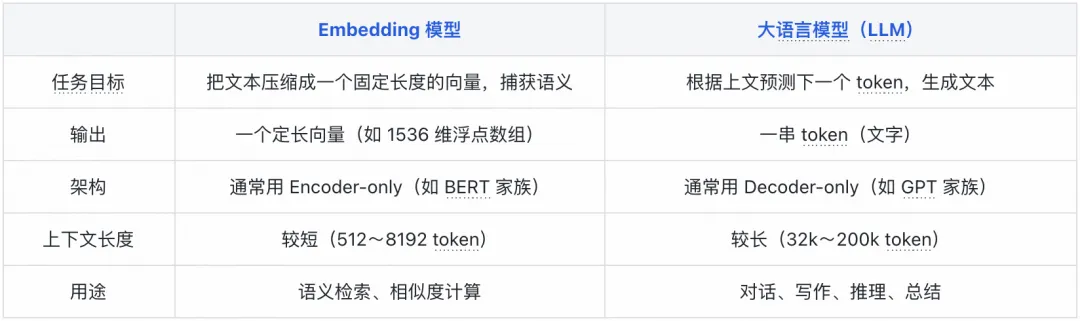
这里有个常见误区值得说清楚——Embedding 模型和 GPT、Claude 这类大语言模型不是一回事,虽然底层都是 Transformer,但目标和结构截然不同:
4. Embedding 模型是怎么训练出来的
很多现代文本检索 Embedding 模型会采用对比学习、排序学习、蒸馏、多任务训练等方式,使正样本对的得分高于负样本对。
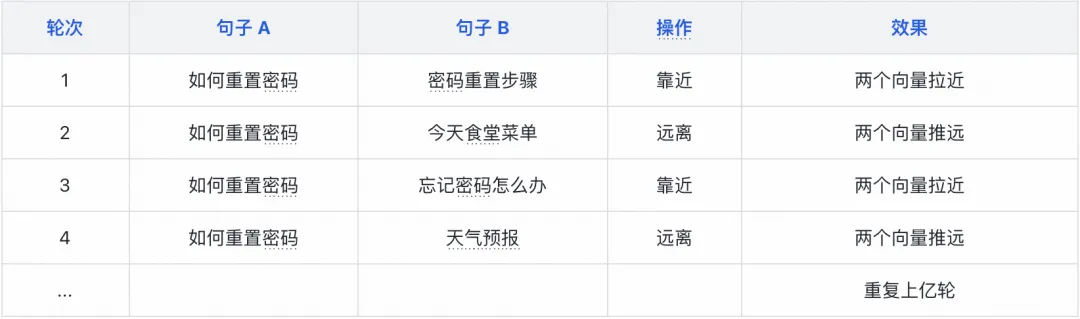
典型训练关系:
Query
├── Positive Document
└── Negative Document训练目标大致是:
score(Query, Positive) > score(Query, Negative)“对比学习”是常见路线,但不能说所有 Embedding 模型都只通过一种统一的 Contrastive Learning 方式训练。
训练数据可能来自:
- 搜索与点击数据;
- QA 数据集;
- 相似句 / 平行语料;
- 人工标注数据;
- 合成 Query-Document 数据;
- Hard Negative Mining;
- 教师模型蒸馏。
模型效果通常受到以下因素影响:
- 语言;
- 领域;
- Query / Document 是否使用不同提示模板;
- 最大输入长度;
- 训练任务;
- 相似度函数;
- 是否做向量归一化。
因此,选模型时应该先看 model card 和官方检索用法,不能只看“向量维度”。
5. Dense 与 Sparse
5.1 Dense Embedding
Dense 向量大多数维度都有非零值:
[0.12, -0.34, 0.07, ...]优势:
- 擅长语义近义;
- 能处理不同措辞;
- 对跨语言、同义表达等场景更友好,具体效果取决于模型。
弱点:
- 对精确编号、错误码、trace ID、型号等精确词项可能不如关键词检索稳定;
- 可能召回“主题相似但答案不相关”的文档。
5.2 Sparse Embedding
Sparse 表示只有少量维度非零,常见方法包括 SPLADE 一类神经稀疏检索模型。
它通常和词项空间有较强联系,更擅长保留词法信号。
5.3 Sparse Embedding 与 BM25 不是一回事
这是一个很容易混淆的点:
- Sparse Embedding:通常由模型产生稀疏表示;
- BM25:经典概率信息检索打分方法,通常基于倒排索引和词频统计。
它们都擅长词法信号,但实现原理不同。
实际 RAG 中最常见的互补组合仍然是:
Dense ANN + BM25三、Chunking:知识怎么切
1. 为什么需要 Chunking
直接把整篇长文档编码成一个向量通常不理想。
原因主要有三类。
1.1 模型输入长度有限
不同 Embedding 模型支持的上下文长度差异很大,从几百 Token 到数万甚至更长都有可能。
因此不要死记:
“Embedding 最大只能 512 / 8192 Token”正确做法是看具体模型文档。
1.2 长文本会造成检索粒度过粗
假设一篇 50 页文档包含几十个主题,却只生成一个向量。
用户问:
退款多久到账?整个文档向量需要同时表示退款、开票、优惠券、账户、物流等大量主题。这样会降低针对局部问题的检索辨识度。
这通常被称为“语义稀释”或“表示粒度过粗”。
1.3 LLM 上下文不是越多越好
即使模型上下文窗口足够大,也没有必要把整篇文档全部塞进去:
- 成本更高;
- 延迟更高;
- 无关内容更多;
- 可能干扰模型定位关键证据。
长上下文研究也表明,模型对不同位置的信息利用并不总是均匀,因此“能塞下”不等于“应该全塞”。
2. Chunk 太小与太大的问题
太小
可能造成:
- 语义断裂;
- 标题丢失;
- 条件和结论被拆开;
- Query 命中某个片段,但答案依赖相邻片段。
太大
可能造成:
- 一个 Chunk 混入多个主题;
- Dense 表示区分度下降;
- Recall precision 降低;
- Rerank 和 LLM 需要处理更多无关 Token。
因此 Chunk Size 本质上是一个需要通过评测调优的超参数,而不是固定答案。
3. 常见 Chunking 策略
3.1 固定长度 Chunk
例如:
Chunk 1: Token 0 ~ 499
Chunk 2: Token 500 ~ 999
Chunk 3: Token 1000 ~ 1499优点:
- 实现简单;
- 性能稳定;
- 适合作为 baseline。
缺点:
- 可能从句子或逻辑单元中间截断。
3.2 Sliding Window / Overlap
例如:
Chunk 1:   0 ~ 499
Chunk 2: 350 ~ 849
Chunk 3: 700 ~ 1199相邻 Chunk 保留部分重叠。
优点:
- 降低边界截断造成的信息损失。
代价:
- 存储量增加;
- 相似 Chunk 增多;
- 查询结果容易重复,需要去重。
3.3 结构化切块
按文档结构切分:
# 一级标题
## 二级标题
段落
列表
表格
代码块例如 Markdown、HTML、Confluence 文档都很适合做结构感知切块。
这类方法更准确地叫:
Structure-aware Chunking / Recursive Chunking
它和严格意义上的“Semantic Chunking”不是完全一回事。
3.4 Semantic Chunking
Semantic Chunking 通常指根据相邻句子 / 段落之间的语义变化决定边界,而不是单纯看到 Markdown 标题就切。
典型思路:
句子 / 段落
  ↓ Embedding
计算相邻单元语义差异
  ↓
在语义跃迁较大的位置切分优点是更贴近内容主题变化。
缺点是:
- 计算成本更高;
- 参数更复杂;
- 并不保证一定优于结构化切分。
3.5 Parent-Child Chunk
思路:
Parent Chunk
├── Child Chunk 1
├── Child Chunk 2
└── Child Chunk 3典型流程:
- 用较小的 Child Chunk 建索引、执行检索;
- 命中 Child 后,根据
parent_id找回更完整的 Parent; - 将 Parent 或扩展上下文送给后续 Rerank / LLM。
目的:
用小粒度提高检索精度,用大粒度保留上下文。
但 Parent-Child 不是所有系统的默认最佳方案,需要考虑:
- Parent 是否过大;
- 多个 Child 是否命中同一 Parent;
- 去重;
- Token Budget;
- Rerank 粒度。
4. Chunking 的工程结论
没有通用最优值。
更合理的做法是建立检索评测集,然后比较:
- Chunk Size;
- Overlap;
- 标题是否前置;
- Parent-Child;
- 结构化切块;
- Semantic Chunking;
- Top-K;
- Rerank 前后的 Recall / NDCG / MRR 等指标。
一个常见起点可以是:
结构化切块
+ 最大长度限制
+ 适量 overlap然后再根据数据做评测,而不是先拍脑袋确定“500 Token 最好”。
四、相似度与距离:怎么衡量“像不像”
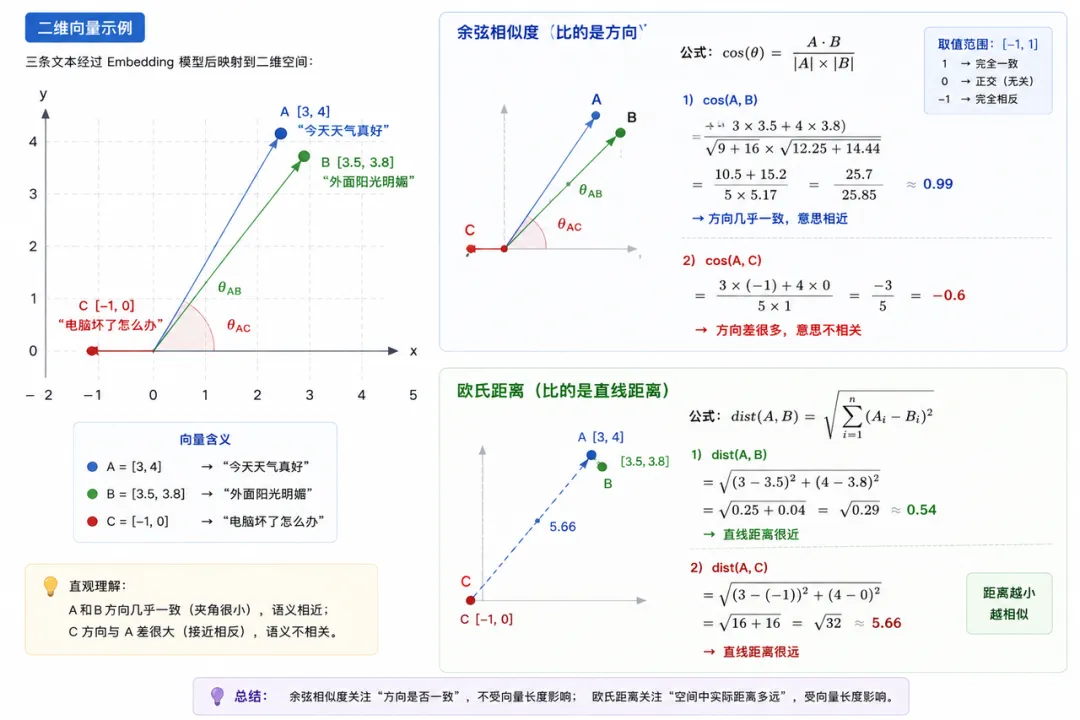
1. 常见度量方式
向量检索常见的度量包括:
- Cosine Similarity;
- Dot Product / Inner Product;
- Euclidean Distance(L2)。
2. 余弦相似度
公式:
cos(A, B) = (A · B) / (||A|| × ||B||)值域:
[-1, 1]1:方向一致;0:正交;-1:方向完全相反。
余弦相似度关注的是方向而不是向量长度。
它在文本 Embedding 中非常常见,但不能简单说:
“所有 Embedding 模型都是按余弦相似度训练的,所以永远选 Cosine。”
这是错误的绝对化表述。
3. Dot Product
公式:
A · B如果 A、B 都经过 L2 Normalize:
||A|| = ||B|| = 1那么:
A · B = cos(A, B)此时使用 Dot Product 可以避免重复归一化。
部分检索模型本身就明确要求 Dot Product,具体必须遵循模型文档。
4. Euclidean Distance
公式:
dist(A, B) = sqrt(Σ(Ai - Bi)²)它衡量的是空间中的绝对距离。
如果向量已经归一化,Cosine、Dot Product 与 L2 之间会存在确定的数学关系,很多情况下排序结果可以等价或高度一致。
5. 正确的工程选择原则
不要记:
“不确定就永远用 Cosine”更准确的原则是:
- 优先遵循 Embedding 模型官方推荐的 similarity metric;
- 确认模型是否要求归一化;
- 确认向量数据库中 metric 的定义;
- 离线评测 Recall@K / NDCG / MRR;
- 再做选型。
6. 一个二维示例
假设:
A = [3, 4]
B = [3.5, 3.8]
C = [-1, 0]余弦:
cos(A, B)
= (3×3.5 + 4×3.8) / (5 × sqrt(3.5² + 3.8²))
≈ 0.994cos(A, C)
= -3 / 5
= -0.6欧氏距离:
dist(A, B)
= sqrt((3-3.5)² + (4-3.8)²)
≈ 0.54dist(A, C)
= sqrt((3+1)² + (4-0)²)
≈ 5.66二维例子只用于解释数学直觉,真实 Embedding 通常工作在高维空间。
五、HNSW:如何快速做近似最近邻搜索
1. 精确 KNN 为什么贵
假设:
N:向量数量;D:向量维度。
对每个 Query 和全部向量计算距离,距离计算本身大致需要:
O(N × D)再从结果中取 Top-K。
百万、千万级数据上,如果每次都全量扫描,成本通常过高。
因此实际系统常使用:
ANN(Approximate Nearest Neighbor,近似最近邻)索引。
ANN 通过少量召回损失换取大幅查询加速。
常见方案:
- HNSW;
- IVF;
- PQ / IVF-PQ;
- DiskANN 等。
不能仅根据“百万 / 千万 / 亿级”直接决定索引类型。真实选型还取决于:
- 内存;
- 向量维度;
- 数据分布;
- 更新频率;
- Recall 目标;
- 延迟目标;
- 过滤条件;
- 是否需要磁盘索引;
- 硬件。
2. HNSW 的核心思想
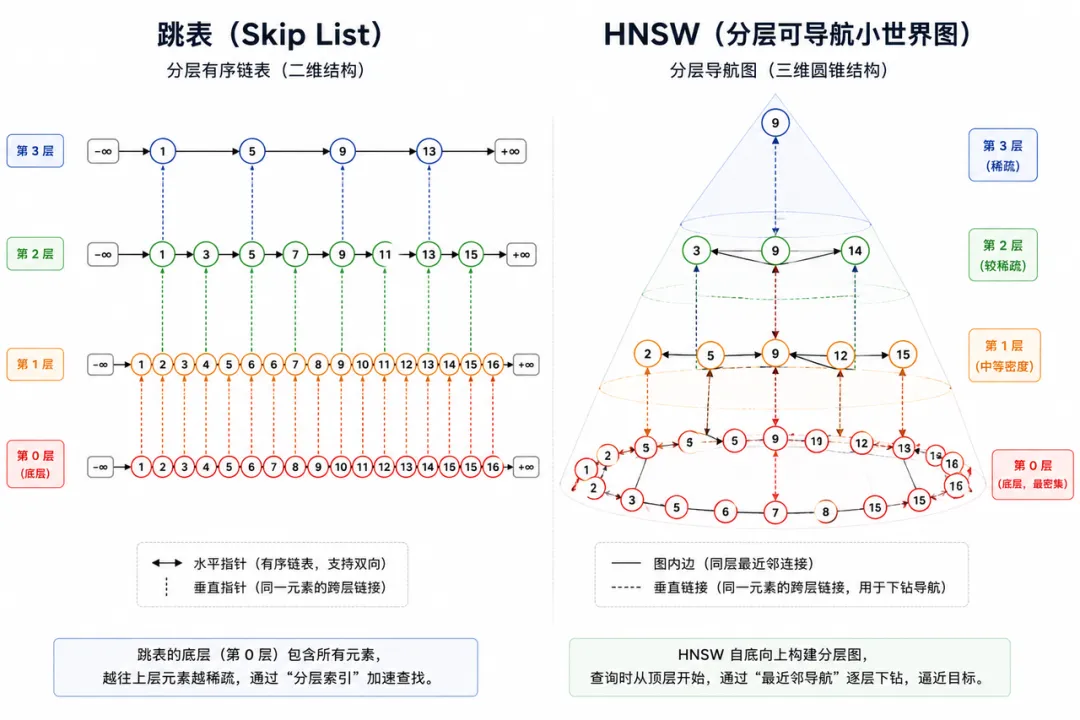
HNSW 全称:
Hierarchical Navigable Small World
可以把它理解为:
NSW 近邻图
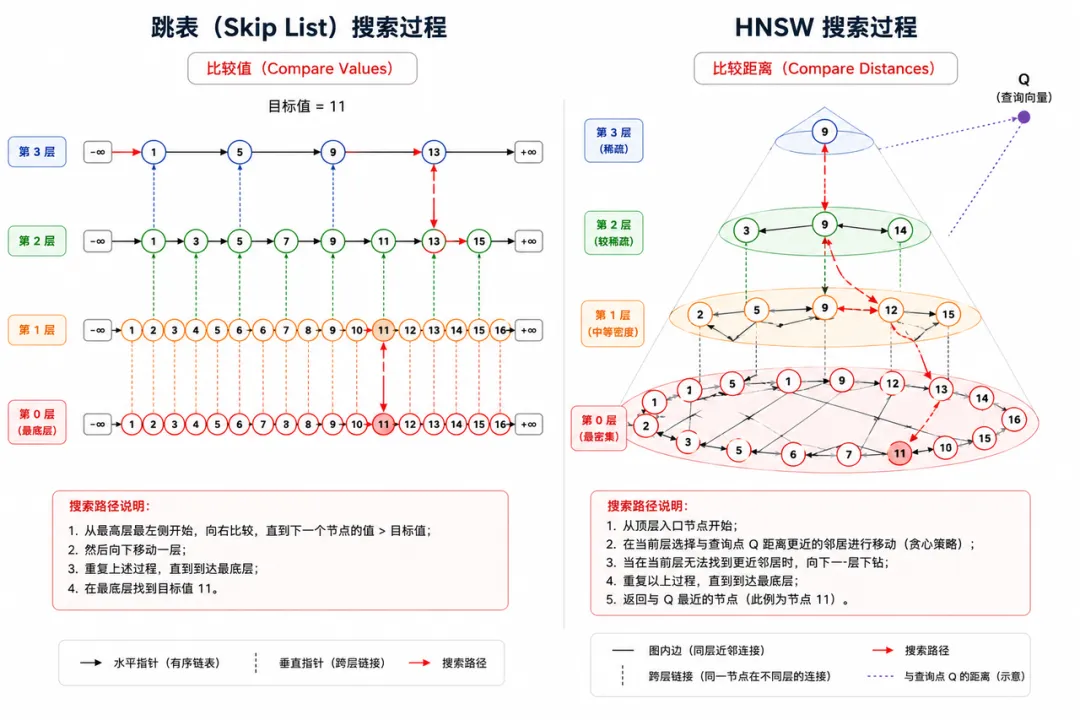
+
分层导航结构它和 Skip List 有“高层稀疏、低层稠密”的结构类比,但 HNSW 不是把跳表原样搬到向量空间。
核心结构:
- 第 0 层包含所有节点;
- 越高层节点越少;
- 搜索从高层入口开始;
- 高层负责快速靠近目标区域;
- 最终在第 0 层进行更充分的候选搜索。
跳表 vs HNSW 的关键区别
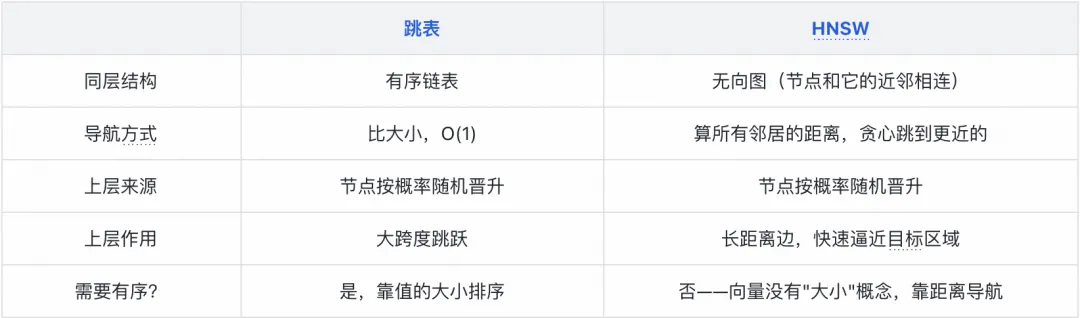
3. HNSW 的层级概率
原论文采用指数衰减的随机层级。
常见写法:
level = floor(-ln(U) × mL)其中:
U ~ Uniform(0, 1)
mL = 1 / ln(M)因此:
P(level ≥ l)
= exp(-l / mL)
= M^(-l)例如 M = 16:
P(level ≥ 1) ≈ 1/16     = 6.25%
P(level ≥ 2) ≈ 1/256    = 0.39%
P(level ≥ 3) ≈ 1/4096 = 0.024%所以:
mL = 1 / ln(M)是层级分布的缩放参数,不是“晋升概率约 36%”。
这是 HNSW 介绍中一个很常见的误读。
4. HNSW 如何构建索引
插入新向量时,大致经历以下过程。
4.1 随机确定最大层级
新节点通过指数分布随机得到最大层级。
它会出现在:
0 ... level这些层中。
4.2 从当前全局入口向下搜索
如果当前索引的最高层高于新节点层级:
- 从最高层入口开始;
- 在每一层进行贪心导航;
- 找到更接近新向量的位置;
- 逐层下降。
4.3 在需要插入的层进行候选搜索
进入新节点参与的层后,不是简单“只找最近 M 个”。
经典 HNSW 会使用候选集合(受 efConstruction 控制)进行更充分的搜索,然后执行邻居选择。
4.4 选择邻居并建立连接
HNSW 经典算法还包含邻居选择启发式,目的是兼顾:
- 距离近;
- 邻居多样性;
- 图的可导航性。
因此不能简单等同于:
“永远连接距离最近的 M 个点”很多经典实现中:
- 上层最大邻居数约为
M; - 第 0 层允许更多连接,常见实现为
2M。
具体实现以使用的向量库 / HNSW 实现为准。
5. HNSW 如何查询
5.1 高层:贪心下钻
从最高层入口开始:
- 查看当前节点邻居;
- 如果存在离 Query 更近的邻居,就移动过去;
- 直到当前层无法继续改进;
- 下降一层;
- 重复。
高层搜索主要用于快速定位大致区域。
5.2 第 0 层:使用 efSearch 扩展候选
真正查询时,第 0 层通常不是只做一次“单路径贪心”。
系统会维护一个动态候选集合,搜索宽度由:
efSearch控制。
直觉:
efSearch 小
→ 检查候选少
→ 延迟低
→ Recall 可能下降

efSearch 大
→ 检查候选多
→ Recall 往往更高
→ 延迟增加最终从候选集中返回 Top-K。
6. 贪心搜索会不会陷入局部最优
会。
因此下面这种说法不准确:
“图天然保证贪心一定不会进死胡同”HNSW 本身就是近似算法,不保证每次找到真实全局最近邻。
它通过以下机制降低局部最优风险:
- 分层长距离连接;
- 高质量邻居选择;
efConstruction;efSearch候选扩展。
所以准确说法是:
HNSW 通过图结构和候选扩展获得很高的经验 Recall,但仍然存在近似误差。
7. HNSW 的三个关键参数
M
控制每个节点维护的邻接关系规模。
通常:
M ↑
→ 图更稠密
→ 内存增加
→ 构建成本增加
→ 高 Recall 场景通常更有利层级分布(以 M=16、晋升概率简化为 1/M 为例):

注:HNSW 论文默认用 mL = 1/ln (M)(M=16 时约 0.36)作为晋升概率,实际 Layer 1 占比约 36%,分布比上表更 “胖”。这里用 1/M 做简化推演,目的是直观展示 “层级越高节点越少” 的指数衰减规律,数量级结论不变。
efConstruction
控制建图阶段候选搜索宽度。
efConstruction ↑
→ 构建更慢
→ 通常得到质量更高的图
→ 可能提高后续 Recall需要重建索引才能改变其建图效果。
efSearch
控制查询阶段候选搜索宽度。
efSearch ↑
→ Recall 通常上升
→ 查询延迟上升它通常可以在查询时调整,无需重建索引。
不同数据库对参数命名和约束可能不同,应以具体实现文档为准。
8. HNSW 的复杂度该怎么理解
原论文和大量实测表明,HNSW 在合适条件下具有很好的近似对数级搜索扩展特性。
但不要把它写成严格的:
“任何数据下最坏复杂度一定是 O(log N)”向量图 ANN 的真实性能还会受到:
- intrinsic dimensionality;
- 图质量;
- M;
- ef;
- 数据聚类程度;
- 删除 / 更新;
- Filter;
- 硬件与实现
影响。
六、完整检索链路:从 Query 到 Rerank
1. Query Rewrite
现实用户可能输入:
那个接口怎么又挂了?而真正可检索的信息可能需要明确为:
支付服务订单创建接口最近一次故障原因是什么?Query Rewrite 可以用于:
- 指代消解;
- 补全业务实体;
- 去掉无意义口语;
- 生成更适合检索的查询;
- Query Expansion;
- Multi-Query。
但 Query Rewrite 不应该无条件应用。
对于本身已经明确的 Query,错误改写反而可能改变用户意图。因此工程上应该通过评测决定:
何时改写
如何改写
是否保留原始 Query 并行召回2. Metadata Filter 与权限过滤
企业场景里,检索通常必须受业务范围约束,例如:
tenant_iduser_iddepartment_iddocument_typeproject_idlanguagetime_range- ACL / RBAC
例如多租户系统:
A 公司用户不能检索到 B 公司文档这不是“相关性排序问题”,而是访问控制问题。
因此权限边界必须在检索系统中被强制执行,不能指望 Rerank 或 LLM 自己过滤。
3. Filter 一定发生在 ANN 之前吗
不一定。
从逻辑上看,我们希望:
在合法候选范围内做搜索但具体向量数据库可能采用:
- Pre-filter;
- ANN 内部 Filter;
- Iterative Filter;
- Post-filter;
- 多阶段混合执行。
例如不同过滤选择率下,数据库可能选择不同执行策略。
因此更准确的说法是:
权限与 Metadata 约束必须正确生效;物理执行顺序由向量数据库及查询计划决定。
4. 多路 Recall
最经典的是:
Recall
├── Dense ANN
└── BM25Dense 擅长语义,BM25 擅长词项。
更完整的系统可能包括:
Recall
├── Dense ANN
├── BM25
├── Sparse Neural Retrieval
├── Graph Recall
├── SQL Recall
├── Memory Recall
├── Conversation Recall
├── Web Search
└── Tool / API Recall不是每个 RAG 都需要全部路径。
核心原则:
问题在哪类数据源中有答案,就应该优先使用能正确访问该数据源的检索方式。
5. 为什么不同检索分数不能直接相加
例如:
Dense:
doc_A = 0.92

BM25:
doc_B = 8.7这两个分数没有统一尺度。
不同检索器的:
- 分值范围;
- 分布;
- 含义;
- 稳定性
都不同。
所以直接:
0.92 + 8.7没有明确统计意义。
可以使用:
- 分数归一化;
- Learning to Rank;
- Weighted Fusion;
- RRF 等。
6. RRF:Reciprocal Rank Fusion
RRF 不直接使用不同检索器的原始分数,而是使用排名。
公式:
RRF(doc) = Σ 1 / (k + rank_i(doc))其中:
rank_i:文档在第 i 路检索中的名次;- 未出现在某路结果中,则该路没有贡献;
k:平滑常数。
原始 RRF 论文实验中使用了:
k = 60因此 60 是非常常见的默认值,但不是不可修改的数学常数。
例:
ANN:
A #1
B #2
C #3

BM25:
B #1
C #2
A #3则:
A = 1/(60+1) + 1/(60+3)
B = 1/(60+2) + 1/(60+1)
C = 1/(60+3) + 1/(60+2)结果:
B > A > CRRF 的优点是:
- 不依赖原始分数尺度;
- 实现简单;
- 对多路排序融合非常实用。
7. Rerank:粗召回之后精排
Recall 的目标通常是:
尽量不要漏掉相关候选。
Rerank 的目标则是:
在候选集合里把真正最相关的排到前面。
典型:
多路 Recall
→ Fusion
→ Top-N,例如 50
→ Rerank
→ Top-K,例如 5
→ LLM50 和 5 只是示例,应该通过评测确定。
8. Bi-Encoder 与 Cross-Encoder
8.1 Bi-Encoder
常见 Dense Retriever:
Query → Encoder → Q
Doc   → Encoder → D

score(Q, D)优势:
- Doc 可以提前离线编码;
- 支持 ANN;
- 查询速度快;
- 能在海量文档中检索。
限制:
- Query 和 Doc 在编码阶段没有完整 token-level 交互;
- 单向量表示存在信息压缩;
- 对细粒度相关性排序可能不如更昂贵的交互模型。
注意:
不能简单说 Bi-Encoder “只能识别主题,无法识别细节”。
优秀的 Bi-Encoder 也能学习细粒度相关性,只是架构上通常更适合高效 Recall而不是最高精度的最终排序。
8.2 Cross-Encoder
典型输入:
[Query] [SEP] [Document]模型同时处理 Query 和 Document,直接输出相关性分数。
优势:
- Query / Doc 可进行更充分的 token-level 交互;
- 通常更适合精排。
缺点:
- 每个 Query-Document Pair 都要重新计算;
- 无法像普通单向量 ANN 那样提前为文档完成最终打分;
- 成本较高。
因此常用于:
Top-N 候选而不是全库检索。
9. Reranker 不一定都是 Cross-Encoder
工程上常见 Rerank 方案包括:
- Cross-Encoder;
- 专用 Reranker 模型;
- Late Interaction;
- LLM Rerank;
- Learning-to-Rank。
Cross-Encoder 是非常典型的一类,但不是“Rerank 的唯一实现”。
10. 推荐的工程流程
对于企业文档问答,一个比较稳妥的 baseline:
Query
  ↓
Query Normalize / Rewrite(按需)
  ↓
ACL + Metadata Constraint
  ↓
Dense ANN ──────┐
                ├─→ RRF / Weighted Fusion
BM25 ───────────┘
  ↓
Top-N
  ↓
Rerank
  ↓
Deduplicate
  ↓
Context Construction
  ↓
Top-K / Token Budget
  ↓
LLM
  ↓
Answer + Citation然后基于离线评测逐个确认:
- Query Rewrite 是否真的增益;
- Dense 与 BM25 各自贡献;
- RRF 是否优于分数归一化;
- Rerank 是否值得额外延迟;
- Chunking 哪种最好;
- Top-N / Top-K 的最佳范围。
不要为了“架构完整”把所有环节都硬塞进去。
七、总结
1. 一张图理解整条链路
                     ┌───────────────┐
                     │     Query     │
                     └───────┬───────┘
                             │
                  Rewrite / Normalize
                       (按需)
                             │
                             ▼
                 ACL / Metadata Constraint
                             │
              ┌──────────────┴──────────────┐
              ▼                             ▼
        Dense ANN                         BM25
        Embedding                    Inverted Index
              │                             │
              └──────────────┬──────────────┘
                             ▼
                       Fusion / RRF
                             │
                             ▼
                          Top-N
                             │
                             ▼
                          Rerank
                             │
                             ▼
                  Context Construction
                             │
                             ▼
                           Top-K
                             │
                             ▼
                            LLM
                             │
                             ▼
Answer + Citation2. 核心结论
Chunking
Chunking 决定“知识以什么粒度被索引”。
关键不是背一个固定 Token 数,而是通过评测找到:
检索粒度 ↔ 上下文完整性之间的平衡。
Embedding
Embedding 把输入映射到向量空间,使语义检索可以通过向量相似度完成。
但:
模型 + 输入模板 + Normalize + Similarity Metric必须配套使用。
Dense + Lexical
Dense 与 BM25 解决的是不同问题:
Dense:语义
BM25:词法 / 精确关键词混合召回通常比单一路径更稳,但是否需要 Sparse Neural Retrieval、Graph、SQL、Memory 等其他路径取决于业务。
相似度
Cosine 很常见,但不是所有 Embedding 的唯一正确答案。
优先遵循模型官方推荐的 metric。
HNSW
HNSW 的本质是:
分层近邻图
+ 高层快速导航
+ 底层候选扩展搜索其中:
M控制图连接规模;efConstruction控制建图质量与成本;efSearch控制查询时 Recall / Latency Trade-off。
RRF
RRF 通过排名而不是原始分数融合多路结果:
Σ 1 / (k + rank)k = 60 来自原始论文中的常用实验配置,不是不可变常数。
Rerank
Recall 追求“别漏”,Rerank 追求“排准”。
Cross-Encoder 是典型 Reranker,但不是唯一方案。
最重要的工程原则
RAG 不是:
Embedding → Vector DB → LLM这么简单。
真正应该优化的是端到端检索质量:
数据质量
→ Chunking
→ Query
→ Recall
→ Fusion
→ Rerank
→ Context
→ Generation并且所有优化都应该尽量落到可量化的评测指标上,而不是靠主观感觉。
校对说明
相较原稿,本版重点修正了以下内容:
- 将“LLM 一定会编造”改为更准确的概率性描述。
- 去掉“GPT-4 的知识停留在某固定时间点”这种易过时的模型特定表述。
- 将 Embedding 训练方式从“统一都是对比学习”修正为“对比学习 / 排序 / 蒸馏 / 多任务等多种路线”。
- 区分了 Structure-aware Chunking 与 Semantic Chunking。
- 去掉 Embedding 最大长度的固定范围结论,改为“按模型文档确认”。
- 修正“Embedding 一定使用余弦训练,因此只能用 Cosine”的错误结论。
- 删除“百万 HNSW、千万 IVF、亿级 DiskANN”这种过度简化的容量选型规则。
- 修正 HNSW 层级概率:
mL = 1 / ln(M)不是 36% 晋升概率;- 常见参数下
P(level ≥ l) = M^-l。
- 修正 HNSW 建图逻辑:
- 不是简单连接最近的 M 个点;
- 经典实现包含候选搜索和邻居选择启发式;
- 第 0 层常允许约
2M个连接。
- 修正 HNSW 查询逻辑:
- 高层偏贪心;
- 第 0 层用
efSearch维护更大的候选集合; - 不是“沿一条路径走到底后返回途中节点”。
- 删除“HNSW 贪心绝不会陷入局部最优”的错误说法。
- 将 HNSW 的
O(log N)表述改为更谨慎的“具有良好的近似对数扩展特性”,避免当作严格最坏复杂度保证。 - 将 Metadata Filter 从“物理上一定先过滤再 ANN”修正为“逻辑约束必须生效,数据库可采用不同执行策略”。
- 明确权限隔离属于访问控制,不应依赖 Rerank 或 LLM。
- 将 Query Rewrite 从“必做高收益步骤”改成“按 Query 类型和评测结果选择”。
- 将 RRF 的
k=60修正为原始论文中常用配置,而不是固定数学常数。 - 修正“Bi-Encoder 因压成 1024 个浮点数所以无法区分细节”的过度简化。
- 补充 Rerank 不只有 Cross-Encoder,一些系统还会使用 Late Interaction、LLM 或 Learning-to-Rank。
参考资料
- Malkov, Y. A., & Yashunin, D. A. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs.
- Cormack, G. V., Clarke, C. L. A., & Buettcher, S. Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods.
- Sentence Transformers Documentation: Similarity Functions / Semantic Textual Similarity.
- hnswlib Documentation:
M,ef_construction,ef. - Milvus Documentation: Filtered Search / Scalar Filtering.
- Liu et al. Lost in the Middle: How Language Models Use Long Contexts.